微信 Bot 消息限流深度排查:从『消息凭空消失』到参数调优
缘起:消息去哪了?
我在 NAS 上部署了个人 AI Agent(Hermes),通过微信 Bot 与它日常交互。最近发现一个恼人的现象:
经常是它发过信息,过一会儿信息却没有送达,需要我再次提醒才能收到回复——而且往往后台任务已经完成,回复内容早就生成好了。
最开始以为是网络问题,后来发现规律性很强:长任务(比如博客迁移、代码改造)进行到一半时,回复必定”凭空消失”。短问题(几秒能答完的)几乎从不丢消息。
于是决定彻底查一次。
第一步:从日志重建时间线
Hermes 的微信网关日志在 logs/gateway.log。先看一次典型的”丢消息”时间线:
1 | 13:49:28 用户发消息(博客迁移需求)→ agent 开始处理 |
规律非常清晰:
- 回复内容早就生成好了(
response ready),只是发不出去 - 限流一旦触发,30 秒内所有消息全部被拦截,而且会反复触发
- 用户再次发消息时(限流窗口已过)就能收到——这就是”需要我提醒才能收到”的真相
第二步:源码定位——发现”熔断器”
打开 Hermes 的微信适配器源码(gateway/platforms/weixin.py),找到了关键机制:
1 | RATE_LIMIT_ERRCODE = -2 # iLink frequency limit — backoff and retry |
微信 Bot 的底层接口(iLink)在发送频率过高时会返回 ret=-2(频率限制)。Hermes 针对这个错误实现了一个熔断器(circuit breaker):
1 | self._rate_limit_circuit_threshold = 1 # 收到 1 次限流就熔断 |
熔断器打开期间,所有发送请求直接拒绝,不再真正调用微信接口。这就是”消息凭空消失”的直接原因——不是微信吞了消息,是 Hermes 自己熔断了,且失败的消息不会排队、不会补发。
第三步:全量统计——反推限流阈值
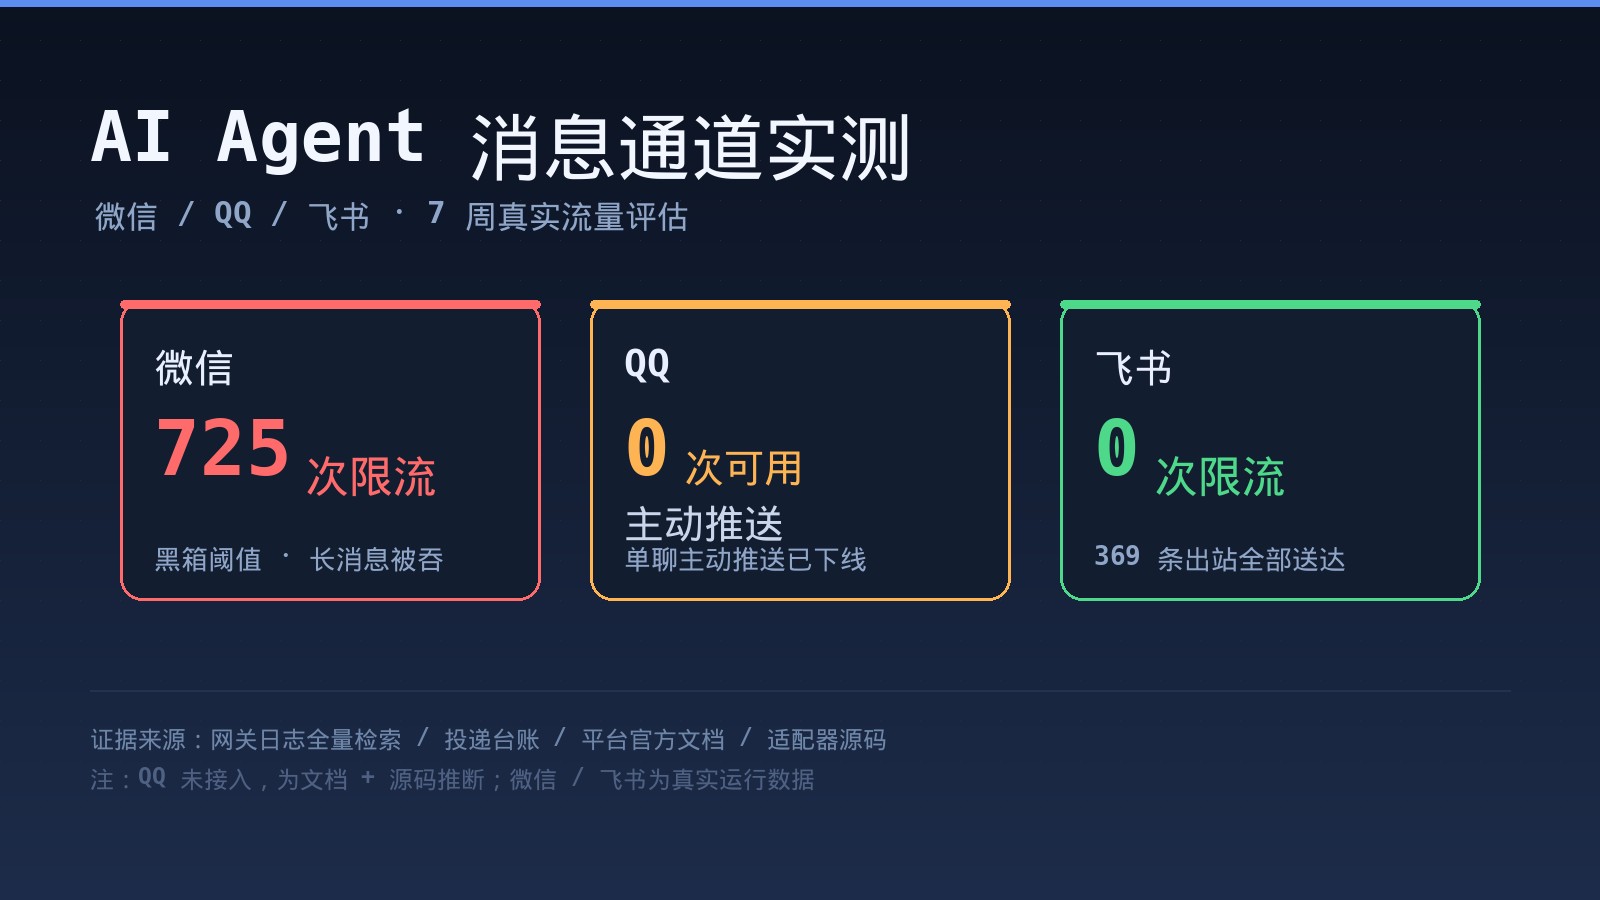
日志里共有 203 条限流失败记录、32 次爆发。我写了脚本统计每次爆发前的”成功发送条数”和”agent 处理时长”:
| 爆发时间 | 前 5min 成功发送 | 前 30min 成功发送 | 首次失败距 inbound |
|---|---|---|---|
| 08-15 12:33 | 0 | 3 | 280s |
| 08-19 13:53 | 0 | 3 | 216s |
| 08-19 20:30 | 0 | 1 | 132s |
| … | … | … | … |
两个关键结论:
- 触发与”消息条数”基本无关——爆发前 5 分钟往往只有 0-3 条成功消息,远谈不上”刷屏”
- 触发与”agent 长任务处理时长”强相关——所有爆发都发生在处理超过 1-2 分钟的任务期间
那真正消耗”频率配额”的是什么?继续翻代码发现:
1 | # _keep_typing:agent 处理期间每 2 秒发一次"正在输入"信号 |
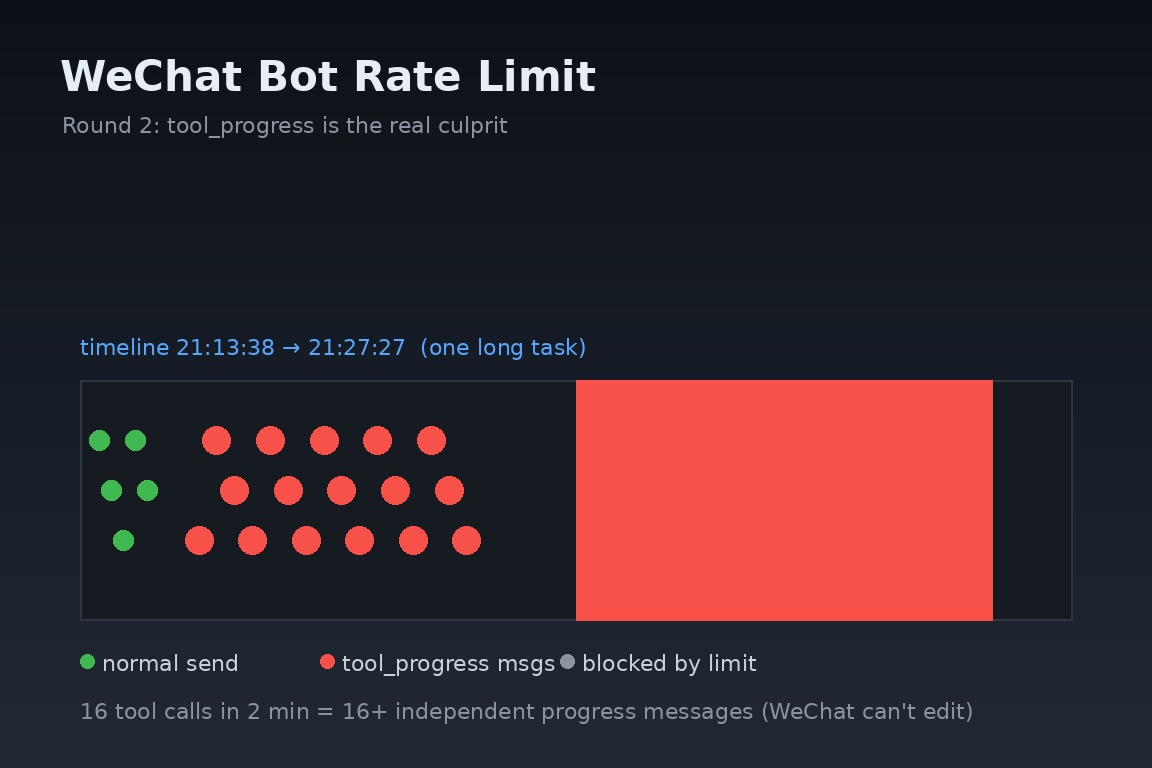
每 2 秒一次的 typing 信号!一个 10 分钟的长任务 = 300 次 typing API 调用,加上 35 秒一次的消息轮询,短短几分钟就能攒下上百次请求——这才是撞上微信频率限制的真凶。
反推阈值:持续高频 API 调用约 2-4 分钟(累计 60-120 次请求)触发限流;触发后限流窗口至少 1-5 分钟(实测最长 427 秒内每次 30 秒熔断重试都撞墙)。
这也解释了为什么”等待型”长任务(下载、睡眠)从不触发——那些任务期间 typing 信号因为会话过期而静默失效,请求量骤降。
第四步:意外发现——“投递义务台账”
排查中还发现 Hermes 有一个良心机制:发送失败的消息不会直接丢弃,而是写入 state.db 的 delivery_obligations 表(投递义务台账),下次 Gateway 重启时自动补发。
1 | 20:31:47 完整报告生成 → 发送失败(限流)→ 记入台账 pending |
所以偶尔会”过一会突然收到一条旧消息”——那是重启后的补发。但两次重启之间被吞的消息会一直躺在台账里,这是体验差的根源之一。
第五步:解决方案——三项参数调优
定位到根因后,解决方案就很明确了:降低 API 请求频率 + 放宽熔断策略。
修改 data/.env:
1 | # 长回复拆条间隔:1.5s → 3s(减少短时消息数) |
修改 config.yaml(关键一步,关掉最大的 API 消耗源):
1 | gateway: |
然后通过 Monitor API 优雅重启 Gateway 生效。
效果与后续
调优后长任务期间不再出现”消息凭空消失”,后台任务完成通知也能及时送达。
核心经验:
- 排障先重建时间线——“消息丢了”不能只看发送失败日志,要结合 inbound / response ready / 后台通知完整还原
- 限流不一定是”发太多消息”——平台的频率限制往往针对全部 API 调用(包括 typing、轮询),高频后台信号才是隐藏的配额杀手
- 熔断器是双刃剑——保护不被打爆,但熔断期间消息不排队不补发,体验上就是”凭空消失”
这次排查从现象到源码、从统计到调优,全程约一晚上。希望这份记录对同样用微信 Bot 跑 Agent 的朋友有帮助。