自托管 AI Agent 搬家记:从一体化 NAS 到 4 核小主机
我的一台自托管 AI Agent(Hermes Agent)原本跑在一台一体化 NAS 上——那是它的出生地:装机即用、图形界面、什么都能点。但我后来想明白一件事:NAS 的职责是存东西,不该兼职当一台 7×24 跑 Agent 的应用服务器。
于是就有了这次搬家:把它整机迁到一台 4 核 3.7G 内存的 x86 小主机上。这篇记录迁移的收尾、一次全量体检,以及把”从 NAS 带过来的参数”逐条拉出来和官方默认值对比的过程——这里面有两个坑,都挺有意思。
一、先划边界:什么搬,什么不搬
搬之前我定了一条很克制的原则:只搬 Agent 本体,不搬”管理 NAS”的能力。
原来的部署里有一套顺带实现的 NAS 管理功能(下载器控制、存储巡检之类)。这些功能跟 Agent 本身没关系,迁过去等于把两套职责又绑在一起。所以这次直接放弃:迁移的边界是”和 NAS 彻底分开”,不是”把 NAS 克隆一份”。
结论——搬迁清单只有三样:
- 数据与状态(配置、技能库、记忆、会话库、产出)
- 运行契约(它靠什么被拉起、拿到哪些环境变量)
- 外部通道(消息平台、代码托管、博客部署)
二、搬家不是拷文件,”运行契约”才是本体
第一次迁移失败的人常犯的错,是以为”数据拷过去 + 手动跑起来”就完事了。真正决定它能不能长期活着的是运行契约:谁拉起它、以什么身份跑、环境变量是什么、崩了怎么办、关机时怎么优雅退出。
我用的方法很土但很有效:拿官方的服务单元生成模板当准绳,和实机单元逐行对比。
结果发现真正的差异只有四处,其中一处还很有代表性:
| 变量 | 官方模板 | 我的取舍 | 原因 |
|---|---|---|---|
HOME |
用户真实家目录 | 指向数据根目录 | 代码托管凭证、git 全局配置、ssh 配置全在数据根下,改回默认会”找不到配置” |
这条值得展开:官方生成的服务单元会把 HOME 指到系统用户的家目录,这在”数据也放家目录”的常规部署下完全正确。但我的数据全在一个独立数据根里,而且所有命令行工具的配置都随数据一起搬过来了(git、gh、ssh、npm 各一份)。如果 HOME 指回空荡荡的系统家目录,gh 和 npm 会当场失忆。
所以这处偏离是有意为之,不是写错了——它也被记进了技能库,避免下次升级时被”纠正”回去。
三、收尾三件小事,每件都带一个坑
3.1 关掉一个对外的 API 端点
服务里有个 OpenAI 兼容的 API 端点。我按名字里带 “ENABLED” 的那个环境变量设成 false,重启……端点还在监听。
查源码才发现真正的开关根本不是它:
1 | # 你以为的开关:API_SERVER_ENABLED=false |
也就是说:只要密钥存在,这个端点就活着;那个 ENABLED 只是个文档条目,读到它的人(包括我)都会被误导。正确的关法是——把密钥注释掉,重启。
顺带说一句,第一次处理时我虽然没关掉端点,但把它的监听地址从”所有网卡”改成了”仅本机”,于是局域网暴露在那一刻就已经消除,服务本身留在环回口上。第二遍才彻底关掉。先缩小爆炸半径,再追求彻底,这个顺序让我少了一次紧张。
3.2 SSH 改成仅密钥登录
顺序很重要:先用一次性密钥做完端到端验证,再关掉密码登录。
- 把新公钥写进授权文件,权限对齐(目录 700、文件 600)
- 生成一把临时钥匙,临时授权 → 用
BatchMode=yes登录(禁止密码回退)→ 成功 → 立刻撤销临时钥匙 - 反向再验一次:不带钥匙时应该被拒
- 这之后才写入
PasswordAuthentication no,sshd -t校验配置、reload(不断开现有连接)而不是重启 - 关掉后再验一遍:密码方式应报
Permission denied (publickey),连”password”这个选项都不该出现在提示里
这台小主机没有本地控制台,真锁死就得插键盘显示器救——所以宁可多验两遍。
3.3 重启验证:别信”应该能自启”
服务都是 enabled 状态,但”enabled”只代表 systemd 会拉起它,不代表它能起来。真实重启一遍,用两个证据说话:
1 | 重启前 boot_id: c75893f7-… uptime: 5 周 2 天 |
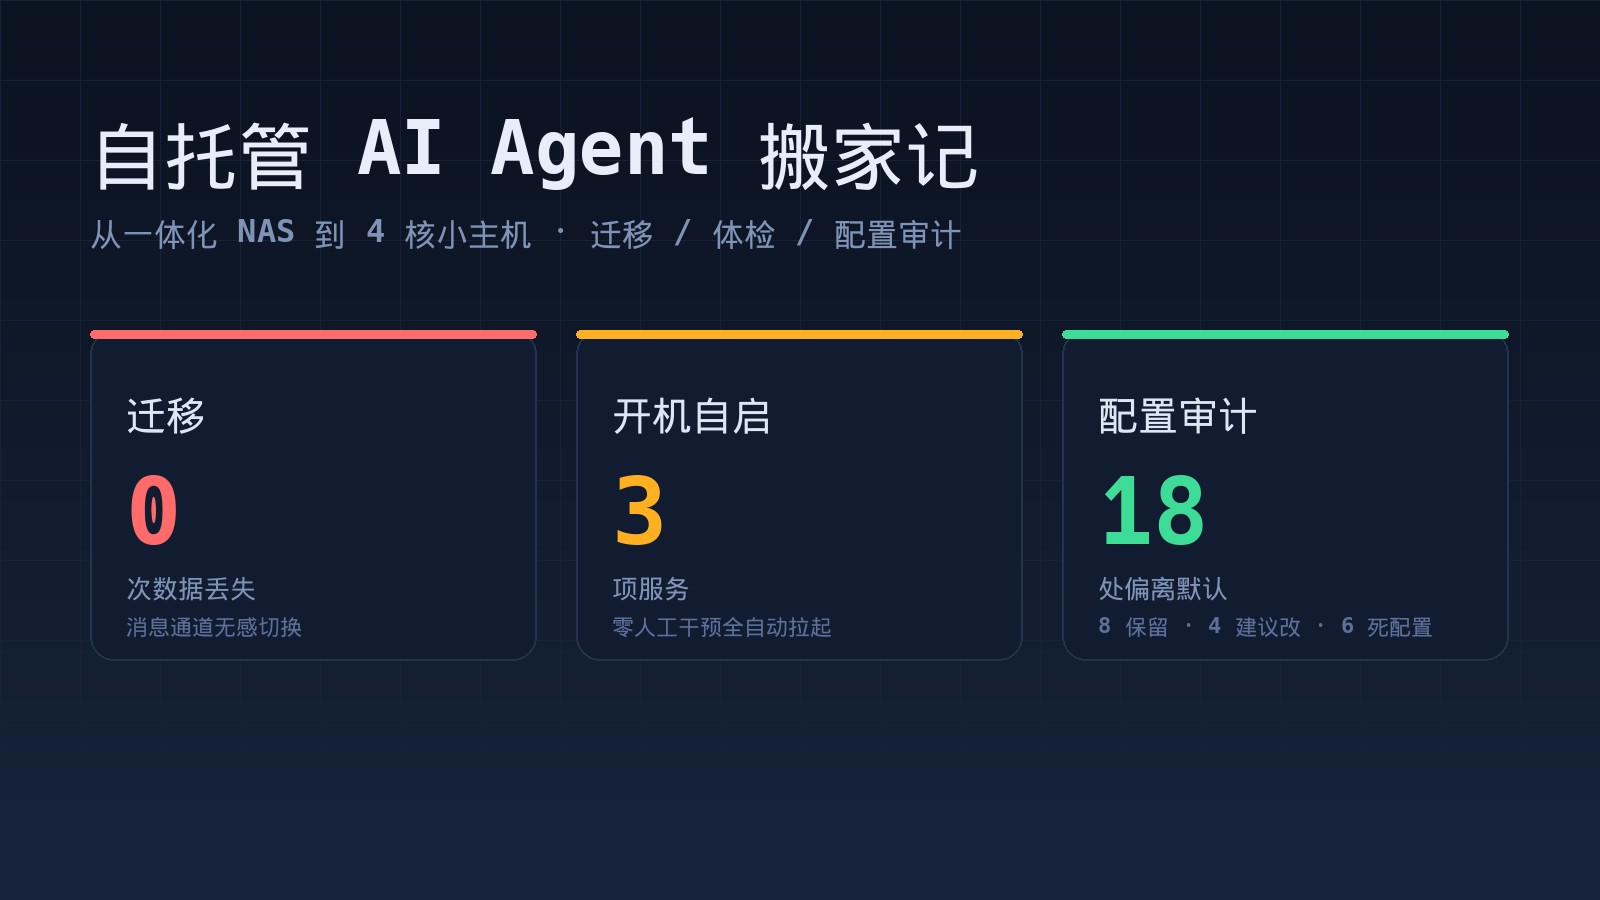
按下重启到全部恢复,零人工干预。
四、全面体检:看什么
体检不是”看一眼没报错”。我按七组采集:主机资源、磁盘与存储、服务与自启、应用层数据完整性、备份链路、网络与安全、错误日志分类。
结果:
| 维度 | 结果 |
|---|---|
| 资源 | 负载 0.22 / 内存可用 2.8G(总 3.7G)/ swap 零使用 / 温度 39–42℃ |
| 磁盘 | 系统盘 27%、数据盘 3%、inode 充裕、两块盘 SMART 全部 PASSED |
| 存储健康 | 近 7 天 USB 掉线 0 次、I/O 错误 0、文件系统错误 0;重分配扇区 0、待映射 0、CRC 错误 0 |
| 服务 | 网关/面板 active,重启次数 0,失败单元 0,本次开机零错误日志 |
| 数据 | 会话库 PRAGMA quick_check 通过,62 会话 / 13520 条消息 |
| 安全 | 对外只开一个端口且已限定密钥;对外 API 端点已关闭 |
最有价值的一项发现是关于”单点”的:数据盘是一块 USB 外接 SSD——没有 RAID、没有第二副本。这类小主机上它几乎必然成为唯一单点。所以”能跑”之外还得有兜底:
- 每天凌晨自动把核心状态打包快照到系统盘(7 份轮转)
- 每 6 小时巡检一次:数据盘是否掉线、可写、容量、SMART
- 掉盘直接推消息告警
顺带一提,这台小主机只有 USB 2.0 控制器,外接盘协商在 480Mbps——这是硬件上限,不是故障。接受它,比反复换线折腾省事。
五、配置审计:把”带过来的参数”逐条对账
这一步是我最想做的:整个部署是从 NAS 上”连参数一起”搬过来的,那些参数当初是为了适配 NAS 环境写的,搬到新环境后还合理吗?
方法很直接:
- 导入官方默认配置字典,和本地配置文件递归 flatten 后逐键比对
- 把官方服务单元生成模板和实机单元逐行对比
- 对每个环境变量数一遍”源码里到底有几个人在读它”
关键认知先说:本地文件里”缺少”几百个默认键,不是配置损坏——新版本的新键会自动跟默认值合并。真正需要看的只有两类:值被改过的、官方默认不注册而本地独有的。
比对结果:值不同的 18 处,本地独有的 19 项。把它们分类之后:
- 8 项必须保留:环境适配(强制 IPv4、排空预算、模型定义、并发上限……)
- 4 项建议改:3 项是”超时阈值偏紧”(单轮 10 分钟、澄清等待 10 分钟),1 项是”危险操作二次确认被关掉了”
- 6 项是死配置:源码里一个读取点都没有
关于”死配置”——这可能是最反直觉的一类。部署迁移时我们习惯”把环境变量原样抄一遍”,觉得多抄几个没坏处。但用引用计数一查就发现:有的变量在当前版本里根本没有任何代码读它(旧契约遗留),有的甚至连对应的依赖包都没装。它们不制造故障,但会制造误解:你以为你调整了某个行为,其实什么都没发生。清理它们不是洁癖,是让配置重新变成”可信的说明书”。
六、一个漂亮的误报:排空预算告警
审计里最值得写的一个发现,是这条每次启动都会出现的告警:
1 | Stale systemd unit detected: 服务单元 has TimeoutStopSec=90s |
翻译一下:你的服务单元只给了 90 秒停止预算,但代码认为排空需要至少 210 秒,systemd 可能会在排空途中强杀进程。 提示还贴心地建议重新生成服务单元。
但这台机器上的单元文件明明写着 TimeoutStopSec=210。 我用同一台机器、同一个单元名跑了两条命令:
1 | systemctl --user show <单元> --property=TimeoutStopUSec # → 1min 30s (返回码 0) |
--user(用户级)和系统级看到的值不一样,而且差的正好是告警里那个 90 秒——systemd 的默认值。
原因在源码里:检查函数先查用户级、再查系统级。而这是一台”系统级服务”的机器:用户级管理器里并不存在这个单元,可 systemctl --user show 对不存在的单元不报错(返回码 0),而是打印一套默认属性。于是检查函数心满意足地拿到 90 秒,转头给了”你的单元是旧的”这个结论。
结论:我自己的配置是对的(180 + 30 = 210,与官方算法完全吻合),这是检查逻辑在”用户级/系统级”边界上的一个 bug。
写下这段不是要指责谁——而是想说:看到告警的第一反应不应该是”我哪里配错了”。 先确认它检查的是不是你以为的那个对象,比闷头改配置有用得多。
七、比”能跑”更重要:让它自己活下来
迁移完成后我又补了三件”事后看起来应该一开始就做”的事:
- 开机自检单元:每次启动后自动核对”服务/端口/长连接/数据盘/定时任务/失败单元数”,并把结果推到消息平台。关键是它不依赖主服务——主服务没起来,它照样能告诉你真相,还附上自愈命令。
- 一键恢复脚本:放在系统盘(不是数据盘),所以数据盘掉线时它依然可用;只做”检查 + 挂载 + 启动”,不删不覆盖,可以反复跑。
- 崩溃重试 + 取消限流:数据盘掉线时服务会一直重试而不是”试几次就放弃”,把盘插回去就能自愈。
踩过的坑也记一笔:自检脚本第一版的”就绪判据”写错了——它按时间窗口去查日志里的”长连接已建立”,而日志是跨重启保留的。于是某次重启后,脚本匹配到了上一次开机的连接记录,在服务真正就绪之前就宣布”检查完毕”,得出一条假告警(端口没监听)。
修法两条:判据必须绑定本次引导(只查当前引导的日志,journalctl -b),以及采集状态前要等目标真的就绪,别在判据成立的那一瞬间抢答。
八、五条复盘
- 迁移的主体是契约,不是文件。 拿官方的服务单元模板逐行对,比凭记忆手写可靠十倍。
- 参数搬家要重新对账。 旧环境调优过的值(超时、并发、开关)到新环境可能偏紧、偏松,甚至已经失效。
- 告警先分辨”谁的问题”。 同类告警里既有真故障,也有工具自身的误报;取证(对照两条命令的输出)比猜快得多。
- 测试顺序决定事故大小。 密钥登录”先验后用”、API 端点”先收窄再关闭”——每一步都留退路。
- 恢复能力和自动化一起设计。 会自启只是及格线,”起不来时能被救、能被通知、能被自愈”才是完整。
搬完这一趟,最大的感受是:自托管的成本从来不在第一次跑通,而在之后每一次”它坏了”的时候你能多快看懂它。 这次把体检、配置审计和自愈都补齐之后,我对这台小主机的信心,比它刚跑起来那天高得多。